分布式数据库海量数据存储与实时查询的实现与应用——数据分析和存储服务演讲实录
各位来宾、各位同事,很高兴今天能在这里与大家分享分布式数据库在海量数据存储与实时查询方面的实现与应用,特别是围绕数据分析和存储服务展开讨论。随着企业数据量呈指数级增长,传统单机数据库在存储容量、并发处理和查询延迟上已难以满足业务需求。分布式数据库凭借其水平扩展、高可用和低成本等优势,成为支撑海量数据存储与实时查询的关键基础设施。我将从架构设计、存储引擎、实时查询优化以及典型应用场景四个方面展开。
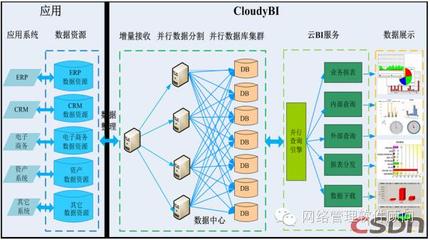
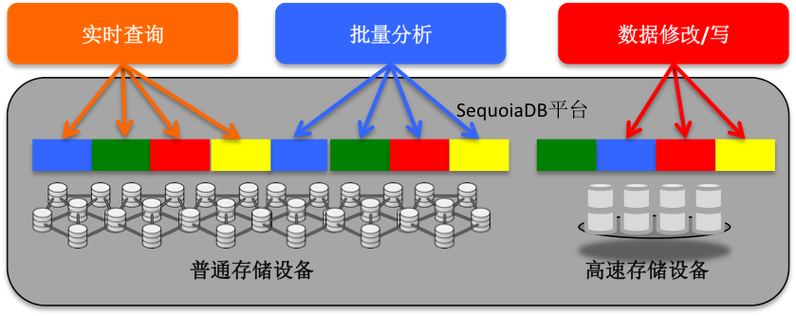
分布式数据库的核心在于数据分片与多副本机制。我们采用一致性哈希进行数据分片,将海量数据均匀分布到多个存储节点,并通过Raft协议实现多副本强一致。每个分片拥有多个副本,主副本负责读写,从副本同步日志并在主副本故障时快速切换。这种设计既保证了数据的可靠性和高可用性,又使得系统能够通过增加节点实现线性扩展,轻松应对PB级数据存储。
存储引擎层面,我们结合了LSM-Tree和列式存储的优势。对于写入密集型的时序数据和分析型数据,采用LSM-Tree结构实现高吞吐写入,并通过后台压缩合并减少读放大。对于需要高效扫描和聚合的分析场景,我们引入列式存储格式,按列进行编码和压缩,大幅降低I/O开销。我们实现了冷热数据分层存储:热数据存放在高性能SSD,冷数据自动下沉至对象存储,在保证查询性能的同时降低存储成本。
第三,实时查询的实现依赖于分布式查询引擎和索引优化。我们采用MPP架构,将查询计划拆分为多个片段并行执行,并通过两阶段聚合减少数据传输。针对点查和范围查询,我们支持二级索引和布隆过滤器,有效减少无效扫描。对于聚合分析,我们引入了向量化执行引擎和预聚合视图,利用SIMD指令加速计算,使复杂查询的响应时间从分钟级降至秒级甚至毫秒级。我们通过全局一致性快照读保证实时查询的数据一致性,满足在线分析对数据新鲜度的要求。
在应用层面,分布式数据库已广泛应用于日志分析、用户行为分析、实时风控和物联网等场景。例如,在用户行为分析中,每天需存储数十TB的埋点数据,并支持多维实时查询。通过分布式数据库,我们实现了数据写入即查询,分析人员可以即时获取用户画像和漏斗转化,支撑业务快速决策。在实时风控场景中,系统需要在毫秒级内完成对交易特征的聚合查询,分布式数据库的高并发和低延迟特性保障了风控规则的实时生效。
分布式数据库通过弹性扩展、分层存储和并行查询等技术,很好地解决了海量数据存储与实时查询的矛盾。我们将继续在存算分离、智能索引和湖仓一体等方向探索,为数据分析和存储服务提供更高效、更智能的底座。谢谢大家!
如若转载,请注明出处:http://www.xspush.com/product/97.html
更新时间:2026-11-21 06:56:17